3 Modelo Matemático de Programación Dinámica Estocástica para Optimizar la Operación de un Sistema Hidroeléctrico.
En este capítulo se presenta una formulación del problema de optimización de la operación de un sistema hidroeléctrico mediante un Proceso de Decisión de Markov (MDP), usando Programación Dinámica Estocástica (PDE) con el fin de obtener la política óptima de operación tomando en cuenta el concepto de curva guía. Se trata de un método exacto, la función de valor almacena como una tabla indexada or los estados discretizados del sistema y se calcula mediante retropropagación de Bellman (Backward induction). Lo anterior se propone tal y como lo describe Díaz (2010), quien aplica la PDE para optimizar la operación del sistema hidroeléctrico del río Grijalva. Se enfatiza la conexión entre los elementos matemáticos formales y su implementación numérica.
3.1 Datos históricos
Sea \(T = 50\) los años históricos disponibles \((1959–2008)\), indexados por \(t \in \{0,\dots,T-1\}\). Cada uno de ellos se subdividieron en \(q = 24\) quincenas (correspondientes a las columnas de los datos históricos proporcionados por Díaz (2010)).
El sistema está compuesto por dos presas: La Angostura \((i = 1)\) y Malpaso \((i =2)\). El volumen de almacenamiento de cada una de ellas en la quincena \(q\) del año \(t\) se representará por \(V_{i,t,q} \in \mathbb{R}_{+} \cup \{0\}\) (Millones de metros cúbicos-\(Mm^3\)).
3.2 Formulación del Proceso de Decisión de Markov (MDP)
Conforme a Puterman (1994), se define el MDP como la colección de objetos \[\{(T, \mathcal{S}, \mathcal{A}, \mathbb{P}, \mathcal{R})\},\] donde cada componente se describe a continuación.
3.2.1 Estructura temporal: quincenas y etapas hidrológicas
Para reducir la dimensionalidad temporal del problema y poder capturar la estacionalidad, las \(24\) quincenas se agrupan en \(M = 6\) etapas hidrológicas (segmentación temporal del año) mediante la siguiente función de agregación \(\mu: \{0,\dots,q-1\} \to \{0,\dots,M-1\}\) definida por \[\mu(q)= \begin{cases} 0, & 0\le q<10 \quad(\text{Ene–May})\\ 1, & 10\le q<14 \quad(\text{Jun–Jul})\\ 2, & 14\le q<16 \quad(\text{Ago})\\ 3, & 16\le q<18 \quad(\text{Sep})\\ 4, & 18\le q<20 \quad(\text{Oct})\\ 5, & 20\le q\le 23 \quad(\text{Nov–Dic}) \end{cases} \tag{3.1}\] así, la variable \(m = \mu(q)\) representará la etapa hidrológica correspondiente a la quincena \(q\).
3.2.2 Espacio de estados y operador de discretización \((\mathcal{S})\)
Se introduce un operador de discretización uniforme \(\mathcal{D}\) del espacio de estados \(\mathcal{S}\) mediante el parámetro \(\Delta = 600\) \(Mm^3\) (paso de discretización). Dicha unidad permite discretizar el volumen almacenado y la afluencia agregada por etapa, así como también, subdividir la capacidad de almacenamiento de cada presa en un número manejable de estados. Para un volumen continuo \(V_{i,t,q},\) se define el operador de discretización \(\mathcal{D}: \mathbb{R} \times \mathbb{N} \longrightarrow \{0,\dots,N-1\}\) dado por \[s_i = \mathcal{D}(V_{i,t,q}, N_i) := \min \left(\max\left(\left\lfloor \frac{V_{i,t,q}}{\Delta} + \frac{1}{2}\right\rfloor, 0\right), N_i-1\right), \tag{3.2}\] donde \(\lfloor \cdot \rfloor\) denota la función piso (redondeo al entero más cercano) y \(N_1 = 27\) y \(N_2 = 16\) son las capacidades discretas máximas de cada presa. El volumen máximo representado en rejilla discreta es \[V_{i,\max} = N_i \Delta, \tag{3.3}\] \(16,200\) \(Mm^3\) para Angostura y \(9,600\) \(Mm^3\) para Malpaso.
Así, el espacio de estados se define como \[\mathcal{S} = \mathcal{S}_1 \times \mathcal{S}_2 \times \{0,...,5\} = \{s = (s_1,s_2,m)\},\] en donde \((s_1,s_2,m)\) representa el volumen discretizado de Angostura, el volumen discretizado de Malpaso y la etapa hidrológica correspondiente a la quincena \(q\).
3.2.2.1 Discretización del proceso de afluencia
A diferencia de la simulación que usa la afluencia histórica \(V_{i,t,q}\) (quincenal), la fase de planeación, trabaja con la afluencia agregada por etapa hidrológica \(m\), esto se debe a que cada paso de la ecuación de Bellman corresponde a una etapa completa. Así, para la presa \(i\), en el año \(t\) y la etapa \(m\), se define la afluencia agregada como \[W_{i,t,m} = \sum_{q:\mu(q)=m} W_{i,t,q}, \tag{3.4}\] y su versión discretizada \[X_{i,t,m} := \max\left(0, \left\lfloor \frac{W_{i,t,m}}{\Delta} + \frac{1}{2}\right\rfloor \right).\]
Lo anterior permite generar, para cada presa, una matriz histórica \(X_{i} \in \mathbb{N}\cup\{0\}^{T\times M}\), las cuales constituyen la muestra empírica sobre la que se construye el modelo probabilístico de transición.
3.2.3 Espacio de acciones \((\mathcal{A})\)
Para cada etapa \(m\), se define una unidad de extracción de agua \(u_m = \{100, 200, 300, 300, 400, 250\}\), así la decisión de operación en la etapa \(m\) corresponderá a los niveles de turbinado \(k_1, k_2\). Cada nivel de turbinado se multiplica por la unidad de extracción \(u_m\), la cual está en \(Mm^3,\) para obtener el volumen de agua extraído en cada presa. Por lo tanto, el espacio de acciones se define como \[\mathcal{A}_m = \mathcal{K}_{1,m} \times \mathcal{K}_{2,m},\] donde \(\mathcal{K}_{1,m} = \mathcal{K}_{2,m}\) representan el conjunto de niveles de turbinado disponibles para ambas presas en la etapa hidrológica \(m\). En la práctica, tanto la Angostura como Malpaso tienen el mismo conjunto de niveles de turbinado y mismas unidades de extracción por etapa.
| \(m\) | \(u_m\) (Mm³) | \(\mathcal{K}_{i,m}\) | turbinado máximo (\(k_m, u_m\)) |
|---|---|---|---|
| 0 | 100 | \(\{0,\dots,20\}\) | 2,000 Mm³ |
| 1 | 200 | \(\{0,\dots,15\}\) | 3,000 Mm³ |
| 2 | 300 | \(\{0,\dots,7\}\) | 2,100 Mm³ |
| 3 | 300 | \(\{0,\dots,9\}\) | 2,700 Mm³ |
| 4 | 400 | \(\{0,\dots,12\}\) | 4,800 Mm³ |
| 5 | 250 | \(\{0,\dots,12\}\) | 3,000 Mm³ |
Una acción denotada por \(a = (k_1, k_2)\), produce el volumen real turbinado \(k_i\cdot u_m\) aplicado simultaneamente en ambas presas. Por ejemplo, suponga que \(m = 0\) entonces \[u_0 = 100 \quad \text{y} \quad \mathcal{K}_{1,0}, \mathcal{K}_{2,0} = \{0,1,...,20\},\] y así \(a = (3,5)\) significaría que Angostura turbina \(3\times 100 = 300\) \(Mm^3\) de agua y Malpaso turbina \(5\times 100 = 500\) \(Mm^3\) de agua. Cabe mencionar que Los valores de \(u_m\) y \(\mathcal{K}_{i,m}\) se seleccionaron para que el turbinado máximo por etapa hidrológica \(k_{i} \cdot u_m\) no exceda la capacidad instalada de las plantas ni los caudales históricos máximos registrados, garantizando la factibilidad física de todas las acciones evaluadas.
3.2.4 Dinámica de transición de estados \((\mathbb{P})\)
Dado el estado físico \((s_1,s_2, m)\) del sistema, una acción \(a = (k_1, k_2)\) y una realización de la afluencia agregada por etapa \((x_1,x_2)\), el cual es un elemento de la muestra empírica (Sección 3.2.2.1), se define el siguiente estado por \[j_i = s_i+x_i-k_iu_m \tag{3.5}\] donde \(s_i\) representa el volumen almacenado en la presa \(i\) (discretizado) antes de tomar la acción de turbinado, \(x_i\) representa el afluente neto discretizado (caudal de ingreso) para la presa \(i\) en la etapa hidrológica \(m\). Por último \(k_iu_m\), representa el volumen de agua extraído por la acción de turbinado aplicada en la etapa hidrológica correspondiente.
La ecuación Ecuación 4.9 representa exactamente la ecuación de continuidad \(j=i+x-k\) que menciona Díaz (2010). En la práctica, el valor \(j_i\) puede exceder los límites físicos del sistema, es decir, puede ser mayor que \(N_i\) (embalse lleno) o menor que \(0\) (embalse vacío). Por lo tanto, se define el estado discreto siguiente \(s_i'\) como \[s_i' = \min(\max(j_i,0),N_i), \tag{3.6}\] lo cual garantiza que el estado discreto resultante esté dentro del rango permitido por la capacidad de almacenamiento de cada presa.
Por lo tanto, el estado discreto siguiente está dado por \[s' = (s_1', s_2', m').\]
Ejemplo numérico. Sea \(\Delta=600\) Mm³, presa Angostura (\(N_1=27\)), etapa \(m=0\) (Ene–May, \(u_0=100\) Mm³). Supóngase que el sistema está en el estado \(s_1=20\) (almacenamiento discretizado \(\approx 20\times600=12{,}000\) Mm³), que la afluencia agregada de la etapa resulta \(x_1=3\) (en unidades de \(\Delta\)) y que la política decide \(k_1=5\) (es decir, turbinar \(v_1=5\times100=500\) Mm³ reales, ec. 2.5). Entonces \[j_1^{\text{raw}}=20+3-5=18,\] que está dentro del rango \(\{1,\dots,27\}\), de modo que no hay derrame ni déficit y el estado siguiente es \(s_1'=18\). Si en cambio \(s_1=27\) (embalse lleno), \(x_1=5\) y \(k_1=0\), entonces \(j_1^{\text{raw}}=27+5-0=32>27\): hay un excedente de \(5\) estados (\(3{,}000\) Mm³) que no cabe en el embalse y que se trata como derrame (§2.9).
Desde el punto de vista de Puterman (1994), la transición de MDP se define mediante una función de probabilidad condicional \[\mathbb{P}(s'|s,a),\] la cual especifica la probabilidad de transicionar al estado \(s'\) dado que se tomó la acción \(a\) en el estado \(s\).
3.2.5 Función de recompensa \((\mathcal{R})\)
3.2.5.1 Modelo hidráulico-energético linealizado
La energía generada depende del volumen de agua turbinado y una aproximación lineal de la altura hidraúlica. Para cada presa \(i\), se define la función de altura \[H_i (s_i,s'_i) =\frac{20(s_i + s_i'+2)}{2} =10 (s_i + s_i'+2). \tag{3.7}\] Tal expresión corresponde a un modelo lineal basado en estados discretizados, el término \(+2\) se introdujo para evitar alturas nulas en estados con bajo volumen y el término \(20\) como intercepto que representa la altura hidráulica mínima mientras que como pendiente representa cuántos metros de altura se ganan por cada incremento en el estado discretizado, es decir, la ganancia por cada incremento de \(\Delta\) en el volumen de agua almacenado.
Sea \(\eta = 0.9\) eficiencia de conversión hidráulica a eléctrica, y \(g = 9.81\) \(m/s^2\) aceleración de la gravedad, entonces la energía generada por la presa \(i\) al tomar la acción \(a\) en el estado \(s\) y transicionar a \(s'\) se define por \[E_i(s,a,s') = \frac{\eta g H_i(s_i,s'_i) (k_iu_m\times 10^6)}{3600\times 10^6}, \tag{3.8}\] donde \(10^6\) representa la conversión de \(Mm^3\) a \(m^3\) y \(3600\times 10^6\) la conversión de \(kWh\) a \(GWh\).
Por lo tanto la energía total generada por el sistema es \[E = E_1+E_2. \tag{3.9}\]
3.2.5.2 Estructura de penalizaciones
La recompensa incorpora penalizaciones para garantizar el cumplimiento de restricciones operativas. Se definen las siguientes penalizaciones:
Penalización por derrame: si \(V_{i,t,q+1} > N_i \Delta\) se aplica \[\Pi_{derr} = C_{derr}\cdot\left(\frac{V_{i,t,q+1}-N_i \Delta}{\Delta}\right) \tag{3.10}\]
Penalización por déficit de agua: si \(V_{i,t,q+1} < 0\) se aplica \[\Pi_{def} = C_{def} \tag{3.11}\]
Penalización por violación de curva guía: si \(s_i' < \text{CG}_i(m)\) se aplica \[\Pi_{CG} = C_{CG}\cdot(s_i'- \text{CG}_i(m)) \tag{3.12}\]
Penalización por niveles críticos (casi desbordamiento): si \(s_i' \geq N_i-1\) se aplica \[\Pi_{crit} = C_{crit} \tag{3.13}\]
donde \(C_{derr}, C_{def}, C_{CG}, C_{crit}\) son constantes de penalización ajustadas empíricamente con valores \(10000, 10000, 5000, 20000\) respectivamente y \(\text{CG}_i(m)\) representa la curva guía para la presa \(i\) en la etapa \(m\).
La función de recompensa total se define finalmente por \[\mathcal{R}(s,a,s') = E - \Pi_{derr} - \Pi_{def} - \Pi_{CG} - \Pi_{crit}. \tag{3.14}\]
En el presente trabajo no se modela una distribución analítica explícita, por lo que en la práctica se construye un dataset empírico basado en datos históricos. La dinámica se construye a partir de trayectorias históricas \[(s_t, a_t, r_t, s_{t+1}')\] en donde cada una de ellas representa una experiencia de transición observada en los datos históricos, siendo \(r_t\) el valor obtenido de la Ecuación 4.21, representando la recompensa obtenida al tomar la acción \(a_t\) en el estado \(s_t\) y transicionar a \(s_{t+1}'\). Este enfoque se alinea con un esquema de Batch Reinforcement Learning.
3.3 Ecuación de optimalidad de Bellman
Conforme a la teoría clásica de control estocástico, por ejemplo Puterman (1994), Teorema 6.2.3, en un MDP descontado existe una única función de valor de acción óptima \(V^*:\mathcal{S}\times\mathcal{A} \to \mathbb{R}\) que satisface la ecuación de optimalidad de Bellman cuando los conjuntos de estados y acciones son finitos: \[V^*(s,a) = \mathcal{R}(s,a,s') + \gamma \sum_{s'\in \mathcal{S}} P(s'|s,a) \max_{a' \in \mathcal{A}} V^*(s',a'). \tag{3.15}\]
Dado que en lugar de una función de transición analítica se cuenta con un dataset empírico de trayectorias \((s_t, a_t, r_t, s_{t+1}'),\) para todo \(t,\) la ecuación de Bellman se reformula en su versión empírica como \[V^*(s,a) = \mathcal{R}(s,a,s') + \gamma \max_{a' \in \mathcal{A}} V^*(s',a'), \tag{3.16}\]
para más detalles consultar Ernst et al. (2005).
3.4 Aproximación numérica mediante Fitted Q-Iteration (FQI)
Si bien es sabido que la programación dinámica estocástica está afectada por la maldición de la dimensionalidad, Castelletti et al. (2010), mientras más variables de estado hayan, el requisito computacional crece exponencialmente, además de que se debe contar con un modelo de transición del sistema explícito, por ello el presente trabajo se basa en un enfoque de aproximación funcional mediante Fitted Q-Iteration (FQI), el cual es un algoritmo de aprendizaje por refuerzo que permite aproximar la función de valor de acción óptima \(V^*\) a partir de un conjunto de transiciones empíricas.
3.4.1 Iteración de Bellman empírica
Al principio, se supone una función de valor de acción inicial \(V^{(0)}\) (\(V^{(0)}(s,a) = 0\) para todo \((s,a)\)). Luego, sucesivamente se generan nuevas aproximaciones para cada iteración \(n\), actualizando la función de valor de acción mediante la ecuación de Bellman empírica. Para cada transición observada \((s_t, a_t, r_t, s_{t+1}')\) en el dataset, se define el objetivo de Bellman por \[y^{(n)} := r + \gamma \max_{a' \in \mathcal{A}} V^{(n-1)}(s',a'), \tag{3.17}\] el cual representa una estimación del valor de acción óptimo asociado al par \((s,a)\) basada en la recompensa obtenida \(r\) y el valor de acción máximo en el estado siguiente \(s'\) según la función de valor de acción de la iteración anterior \(V^{(n-1)}\).
3.4.2 Aproximación funcional por regresión no paramétrica (ExtraTrees)
Una vez calculados los objetivos de Bellman \(y^{(n)}\) Ecuación 4.25, se ajusta una función de valor de acción \(V^{(n)}\) que aproxime la relación entre los pares \((s,a)\) y los valores objetivos \(y^{(n)}\), dicha función se obtiene resolviendo un problema de aprendizaje supervisado que se explicó en la sección (pendiente).
El procedimiento se formula como un problema de regresión no paramétrica, en donde se busca encontrar una función \(V^{(n)}\) que minimice el error entre las predicciones \(V^{(n)}(s,a)\) y los objetivos \(y^{(n)}\) para todas las transiciones \((s_t, a_t, r_t, s_{t+1}')\) en el dataset. En la práctica, se utiliza el algoritmo de ExtraTrees, que como propone Ernst et al. (2005), el cual argumenta que ofrece gran flexibilidad para aproximar funciones de valor en espacios continuos o de alta dimensionalidad.
La modelación mediante ExtraTrees compuesto por \(300\) árboles de decisión, con una profundidad máxima de \(14\) y un mínimo de \(5\) muestras por hoja. Cada árbol de decisión particiona el espacio estado-acción en regiones homogéneas, (grupo de \((s,a)\) similares) y proporciona una estimación local de la función de valor. La predicción final corresponde al promedio de las predicciones individuales de todos los árboles de decisión.
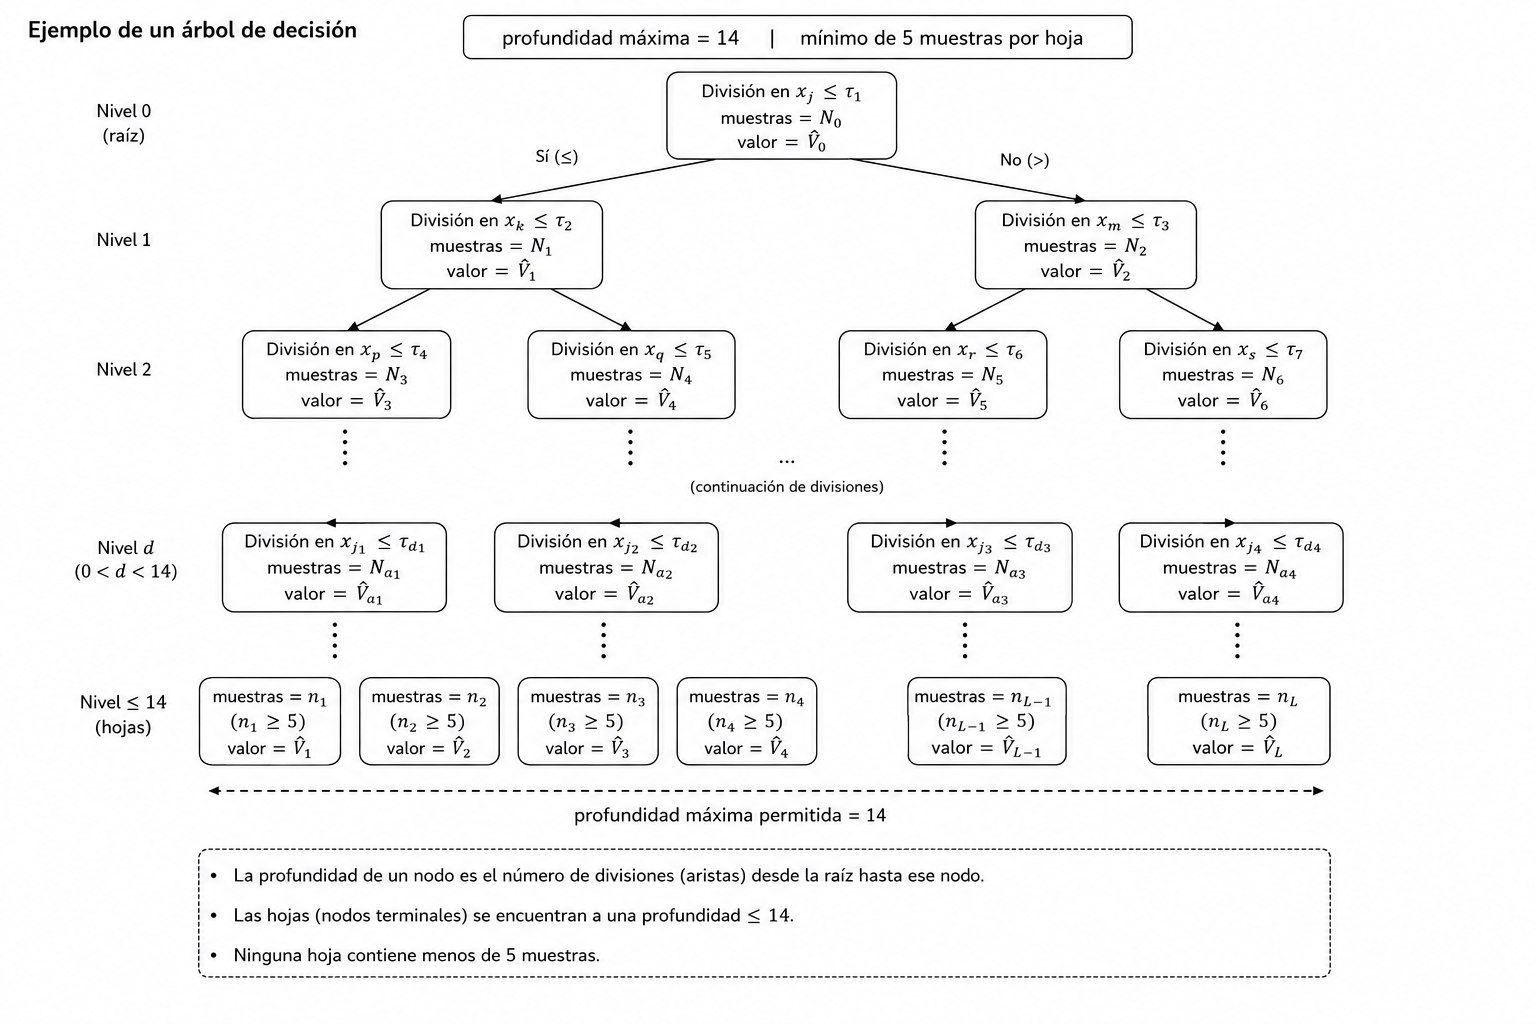
El algoritmo de FQI se repite iterativamente hasta que la función de valor de acción converge. En la práctica se definió una métrica de convergencia empírica por \[\Delta = \frac{1}{L}\sum_{l=1}^L |V^{(n)}(s_l,a_l) - V^{(n-1)}(s_l,a_l)|, \tag{3.18}\] la cual se define sobre \(\mathcal{T} \subset \{(s_t, a_t, r_t, s_{t+1}')\}\) siendo \(L\) la cardinalidad de \(\mathcal{T}\).
Por lo que el algoritmo se detiene hasta que el \(\Delta < \epsilon\), es decir, cuando el cambio entre \(V^{(n)}\) y \(V^{(n-1)}\) sea menor a un umbral predefinido o bien cuando se alcance un número máximo de iteraciones.
3.5 Política óptima y simulación operativa
Una vez obtenida la función de valor de acción óptima \(V^*,\) se deriva la política óptima \(\pi^*:\mathcal{S} \to \mathcal{A}\) que asigna a cada estado \(s\) la acción \(a\) que maximiza el valor de acción \[\pi^*(s) := \arg\max_{a \in \mathcal{A}} V^*(s,a), \tag{3.19}\]
es decir, para cada estado \(s\), la política óptima \(\pi^*(s)\) indica la acción que se debe tomar para maximizar el valor de acción estimado.
Finalmente, se valida la política óptima \(\pi^*\) mediante simulación en lazo cerrado, es decir, se simula la operación del sistema hidroeléctrico utilizando la política \(\pi^*\) para tomar decisiones de turbinado en cada estado observado durante las trayectorias históricas.
La evaluación de la política se realiza mediante un recorrido determinista sobre la serie histórica completa. El algoritmo opera de la siguiente manera:
Inicialización: Se fijan los volúmenes iniciales \(V_{1,0}\) y \(V_{2,0}\).
Mapeo estacional: Para cada quincena \(q\), se determina \(m = \mu(q)\) y la unidad de extracción \(u_m\).
Discretización:
\[s_i = \mathcal{D}(V_i,N_i), \quad i\in\{1,2\}.\]
Selección de acción:
\[(k_1^*,k_2^*) = \arg\max_{k_1,k_2}\hat{V}^{*}(s,a),\]
donde
\[(s,a)=(s_1,s_2,m,k_1,k_2).\]
Balance hídrico:
\[V_{i,t,q+1} = V_{i,t,q} + W_{i,t,q+1} - k_i^*u_m.\]
Proyección física:
\[V_i^{\text{new}} = \min\{V_{i,t,q+1},N_i\Delta V\},\]
\[\text{derrame}_i = \max\{0,V_{i,t,q+1}-N_i\Delta V\}.\]
Cálculo energético:
\[H_i = 10\left(s_i+\mathcal{D}(V_{i,t,q+1},N_i)+2\right),\]
\[E_i(s,a,s') = \frac{\eta g H_i(s_i,s'_i)\left(k_i^*u_m\times10^6\right)} {3600\times10^6}.\]
Registro y actualización: Se almacenan métricas de energía, derrames y volúmenes, y se actualiza el estado para la siguiente iteración.
La metodología sigue la práctica estándar en aprendizaje por refuerzo aplicado a sistemas de control documentado en Bertsekas (2019), en el cual la política aprendida se valida mediante una simulación en lazo cerrado sobre trayectorias históricas.
3.5.1 Métricas de desempeño y validación estadística
Una vez obtenidos los resultados de la simulación en lazo cerrado, se evalúa el desempeño de la política óptima \(\pi^*\) utilizando métricas clave como las siguientes:
| Métrica | Angostura | Malpaso | Sistema Total |
|---|---|---|---|
| Energía promedio quincenal [GWh] | 242.85 | 139.92 | 382.78 |
| Energía anual estimada [GWh] | 4,857 | 2,798 | 7,656 |
| Contribución al sistema [%] | 63.4 | 36.6 | 100.0 |
Por otro lado, los derrames promedio quincenales y anuales se presentan en la siguiente tabla:
| Métrica | Angostura | Malpaso | Sistema Total |
|---|---|---|---|
| Derrame total [Mm^3] | 7,722.10 | 26,330.80 | 34,052.90 |
| Derrame promedio Anual [Mm^3] | 154.44 | 526.62 | 681.06 |
De acuerdo con los resultados obtenidos y con la información obtenida de Díaz (2010), se observa que la política no está gestionando adecuadamente los recursos hídricos, ya que el volumen de agua derramada es considerablemente alto, lo que sugiere que la política aprendida no está optimizando eficientemente el uso del agua disponible para generación energética. Además, la contribución energética de cada presa al sistema total no refleja un balance adecuado, lo que podría indicar que la política está favoreciendo excesivamente una presa sobre la otra, lo que no es deseable desde el punto de vista de la gestión integrada del sistema hidroeléctrico. Estos resultados sugieren que la política óptima aprendida mediante FQI no está logrando un equilibrio adecuado entre la generación de energía y la gestión eficiente del recurso hídrico, lo que podría requerir una revisión de la formulación del problema, la función de recompensa o la metodología de aprendizaje utilizada para mejorar el desempeño del sistema en términos de ambos objetivos.
3.6 Conclusiones del capítulo
- Síntesis de contribuciones matemáticas y numéricas.
- Reafirmación de la coherencia entre formulación teórica, implementación algorítmica y validación operativa.
- Declaración de cierre alineada con los objetivos de la tesis.